Detección de bots falsos de IA en los logs del servidor
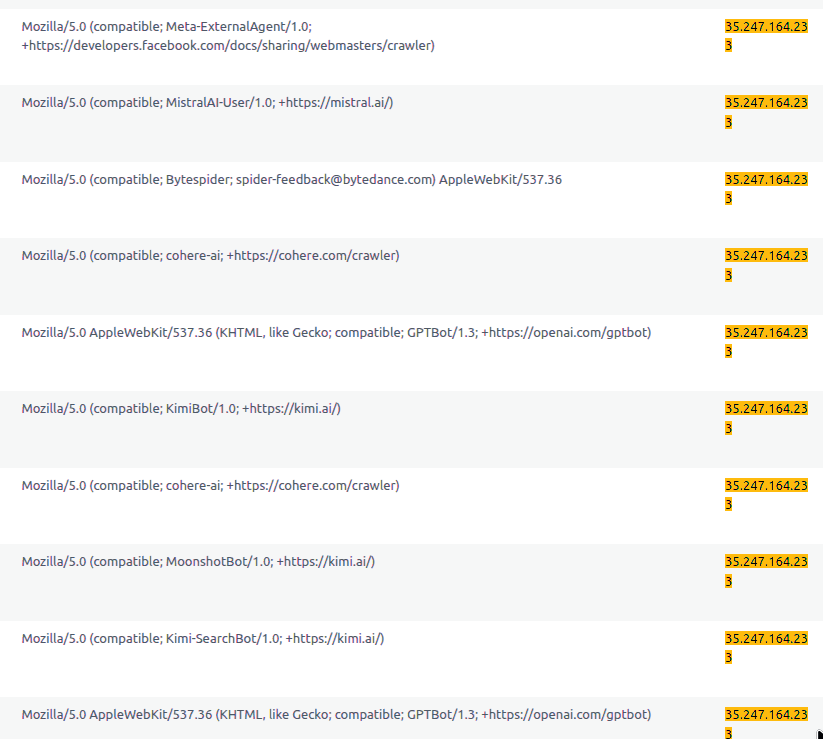
Hay una escena cada vez más habitual en los registros de servidores: una misma dirección IP realiza peticiones con nombres de bot completamente distintos. Primero dice ser Meta-ExternalAgent, después MistralAI-User, luego Bytespider, Cohere, GPTBot, KimiBot… y, unos segundos después, vuelve a empezar.
No, no es que varias empresas de inteligencia artificial hayan decidido compartir piso de estudiante.
En muchos casos estamos simplemente ante un cliente automatizado que modifica deliberadamente su cabecera User-Agent para intentar parecer otro tipo de crawler.
La imagen que acompaña este artículo es un ejemplo bastante ilustrativo: desde una misma IP aparecen sucesivamente distintos identificadores asociados a conocidos rastreadores y servicios de IA. El patrón resulta especialmente interesante cuando estas peticiones se combinan con búsquedas de archivos sensibles, rutas administrativas o recursos que no deberían estar públicamente expuestos.
La idea es sencilla: si el servidor toma decisiones basándose únicamente en lo que el cliente dice ser, mentir puede salir gratis.
El User-Agentes una tarjeta de visita que cualquiera puede imprimir
Cuando un navegador, crawler, aplicación o script realiza una petición HTTP, normalmente incluye una cabecera parecida a:
User-Agent: Mozilla/5.0 ...Esta cadena permite al servidor saber (o, mejor dicho, creer) qué tipo de cliente está realizando la petición.
Por ejemplo, un crawler legítimo puede identificarse explícitamente:
Mozilla/5.0 (compatible; GPTBot/1.3; +https://openai.com/gptbot)Otro puede utilizar:
Mozilla/5.0 (compatible; Bytespider; spider-feedback@bytedance.com)Y otro:
Mozilla/5.0 (compatible; MistralAI-User/1.0; +https://mistral.ai/)El problema es que HTTP no incluye un notario que certifique que el User-Agent dice la verdad.
Un atacante puede escribir prácticamente cualquier cosa ahí.
Podría incluso presentarse como:
Mozilla/5.0 (compatible; DefinitelyNotAHacker/1.0)y el servidor tendría que decidir qué hacer con esa información.
Recuerdo cuando una app solo dejaba acceso con Chrome y no con mi navegador Opera. Bastó cambiar el user agent de Opera por uno de Chrome y ya tuve acceso a la aplicación. Según esa empresa solo funcionaba en Chrome.
Cambiar el User-Agent no convierte al atacante en el bot
Conviene hacer una distinción importante.
Que una petición diga:
GPTBotno significa que proceda realmente de GPTBot.
Del mismo modo:
MistralAI-Userno demuestra que la petición provenga de Mistral.
El User-Agent es fundamentalmente una declaración del cliente, no una prueba criptográfica de identidad.
Por eso, observar una cadena como:
GPTBot/1.3en un log no debería ser suficiente para concluir que OpenAI ha visitado el servidor.
Y exactamente lo mismo ocurre con otros crawlers.
¿Por qué los hackers cambian su user-agent?
Aquí es donde el asunto se vuelve interesante.
Un sistema de seguridad mal diseñado podría hacer cosas como:
Si User-Agent = crawler conocido
    permitir
o:
Si User-Agent = navegador
    aplicar una política

Si User-Agent = bot
    aplicar otra
Esto puede generar una oportunidad para quien está haciendo reconocimiento.
El atacante puede probar diferentes identidades y observar si alguna produce un comportamiento diferente.
Es, salvando las distancias, como llegar a un edificio diciendo:
(Buenos días, soy mantenimiento.
Si el guardia responde:
Ah, entonces pase usted, las humedades están al fondo a la derecha en la sala de las obras de artes.
el problema no era que el visitante supiera abrir la puerta.
El problema era que el guardia confiaba demasiado en la etiqueta del visitante.
¿Qué nos dice la imagen sobre el posible atacante?
El aspecto llamativo de la captura no es solamente que aparezcan muchos User-Agent.
Es que la misma dirección IP aparece repetidamente asociada a identificadores diferentes.
Entre ellos se observan cadenas correspondientes a:
- Meta External Agent
- MistralAI
- Bytespider
- Cohere
- GPTBot
- KimiBot
- MoonshotBot
- KimiSearchBot
Y posteriormente vuelven a aparecer algunos de ellos. Y muchos más que no cabían en la imagen recortada.
Esto no demuestra por sí solo que todos esos servicios sean responsables del tráfico.
De hecho, cuando múltiples identidades de crawler aparecen desde la misma IP y dentro de una actividad de reconocimiento, una explicación razonable es que un único sistema automatizado esté modificando el User-Agent entre peticiones.
Es una técnica extremadamente sencilla.
No hace falta una máquina del tiempo, una inteligencia artificial malvada ni una sala llena de monitores verdes.
Basta con cambiar una cadena de texto.
¿Qué buscaba el tráfico de esa IP ?
Aquí está la parte mucho más importante desde el punto de vista de seguridad. Desde esa IP se buscaban archivos de configuración y de acceso.
Un archivo .env puede contener información que nunca debería estar disponible directamente desde Internet, dependiendo de cómo esté configurada la aplicación.
Por ejemplo, puede contener variables relacionadas con:
DATABASE_URL
API_KEY
SECRET_KEY
PASSWORD
TOKEN
El contenido concreto depende de la aplicación, pero el principio es el mismo:
los archivos de configuración y secretos no deberían ser recursos públicos del servidor web.
Por eso, durante una fase de reconocimiento automatizado, un atacante puede intentar determinar si existen determinados recursos expuestos accidentalmente.
Y .env es especialmente atractivo porque históricamente ha sido frecuente que aplicaciones web lo tengan en el directorio del proyecto debido a cómo funcionan determinados frameworks y sistemas de despliegue.
Eso no significa que un servidor que reciba una petición relacionada con .env esté comprometido.
Significa que alguien está comprobando si existe una exposición potencial.
Bots que recorrer todo internet en busca de datos de acceso y vulnerabilidades
Muchos incidentes de seguridad empiezan de una manera bastante menos espectacular de lo que muestran las películas.
No comienza necesariamente con:
HACK THE PLANET
Comienza con algo mucho más aburrido:
GET /...
GET /...
GET /...
GET /...
El objetivo puede ser descubrir:
- tecnologías utilizadas;
- frameworks;
- paneles administrativos;
- rutas conocidas;
- archivos de configuración;
- backups;
- repositorios expuestos;
- endpoints olvidados;
- versiones de software;
- configuraciones incorrectas;
- recursos que no deberían ser accesibles públicamente.
Esta fase se conoce habitualmente como reconocimiento o enumeration.
Y es precisamente aquí donde los logs pueden convertirse en una fuente de información extraordinariamente útil.
El error de pensar que el User-Agent es una medida de seguridad
Una de las conclusiones más importantes para cualquier administrador es ésta:
El
User-Agentsirve para identificar clientes, no para autenticar clientes.
Si una aplicación tiene una regla como:
if User-Agent == "Googlebot":
    allow
eso no constituye una autenticación.
Y si existe:
if User-Agent == "GPTBot":
    trust
tampoco.
Un cliente puede enviar:
User-Agent: GPTBotsin tener absolutamente ninguna relación con GPTBot.
Por tanto, cualquier mecanismo de seguridad basado exclusivamente en esa cabecera debería considerarse extremadamente débil.
¿Puede cambiar el User-Agent dar acceso?
Por sí mismo, normalmente no.
Cambiar el User-Agent no proporciona mágicamente permisos adicionales ni convierte una petición anónima en una petición autenticada.
La ventaja, cuando existe, procede de cómo está configurado el sistema que recibe la petición.
Por ejemplo, una aplicación podría:
- aplicar reglas diferentes según el User-Agent;
- excluir determinados bots de controles;
- permitir rastreadores en rutas concretas;
- utilizar el User-Agent en reglas de WAF;
- generar respuestas distintas;
- registrar unas peticiones y no otras;
- aplicar límites de velocidad diferentes.
Si alguna de esas decisiones está mal implementada, la falsificación puede resultar útil para el atacante.
En otras palabras:
el atacante no rompe el mecanismo de seguridad falsificando el User-Agent; intenta aprovechar un mecanismo de seguridad que confía incorrectamente en él.
La pequeña paradoja de los bots de IA
Hay además una ironía bastante curiosa.
Los nombres de crawlers legítimos de empresas de IA están diseñados precisamente para permitir que los administradores puedan reconocerlos.
Eso es útil.
Pero esa misma visibilidad hace que sus nombres sean también cadenas perfectas para falsificar.
Un atacante puede pensar:
«Si digo que soy un crawler conocido, quizá alguna regla me trate de forma diferente.»
Es la versión digital de ponerse un chaleco reflectante y caminar con una carpeta diciendo:
«Inspección rutinaria.» ¿Cuántos atracos se cometen en el mundo por ladrones vistiendo de operarios? Recordad el robo del Louvre.
Cómo interpretar correctamente este tipo de logs
Un único User-Agent sospechoso no dice demasiado.
Es mucho más interesante observar el patrón completo.
Por ejemplo:
| Indicador | Qué puede sugerir |
|---|---|
| Una IP genera muchas peticiones | Automatización potencial |
| Cambios frecuentes de User-Agent | Posible suplantación o rotación |
| Muchos crawlers diferentes desde una IP | Merece investigación |
| Peticiones a archivos sensibles | Reconocimiento |
| Peticiones a rutas administrativas | Enumeración |
Muchas respuestas 404 | Descubrimiento de recursos |
| Peticiones muy rápidas y repetitivas | Cliente automatizado |
| Intentos sobre archivos de configuración | Búsqueda de exposición |
| User-Agent declarado y comportamiento incompatible | Identidad posiblemente falsa |
Ninguno de estos indicadores demuestra por sí solo una intrusión.
Pero la combinación de varios aumenta considerablemente el interés del evento para el análisis de seguridad.
Poner trampas estilo honeypot puede ser lo más útil. Por ejemplo, usar como trampa los logins de los CMS más populares. El famoso wp-login.php. Si alguien quiere acceder a ese archivo se banea la IP durante un mes. Hacer lo mismo con ficheros de shell, ficheros estáticos donde buscan contraseñas en texto plano…
No bloquear solamente por User-Agent
Una respuesta habitual ante este tipo de tráfico es:
«Bloqueemos todos los GPTBot.»
Puede ser útil en determinados escenarios, pero no resuelve el problema fundamental.
Si el atacante puede cambiar:
GPTBotpor:
Googleboty después por:
Chromeel bloqueo basado exclusivamente en el nombre es una carrera bastante absurda. Tuve un cliente que baneo a estos bots y se encontró su web desindexada por google en una semana. El administrador de sistemas no se dio cuenta que bloquear al bot de google, Bing e IA conlleva desaparecer de internet, el fracaso del proyecto y la pérdida de su puesto de trabajo. Esto último no pasó. Supongo que sería un junior con poco bagaje en el sector.
Es como prohibir la entrada a alguien porque lleva una camiseta roja cuando esa persona puede cambiarse la camiseta.
Entonces, ¿qué debería mirar un administrador de sistemas en los logs de servidor?
Mucho más que el User-Agent.
Entre los elementos que pueden aportar contexto están:
1. Dirección IP
Permite agrupar las peticiones y detectar patrones.
En la captura proporcionada, por ejemplo, resulta relevante que diferentes identificadores aparezcan asociados a la misma dirección.
2. Frecuencia
Una secuencia de cientos o miles de solicitudes en poco tiempo tiene un significado diferente a una visita ocasional.
3. Rutas solicitadas
No es lo mismo solicitar:
/que realizar repetidamente solicitudes dirigidas a archivos de configuración, backups o interfaces administrativas.
4. Código HTTP
Los 200, 403, 404, 429 y 5xx pueden ayudar a reconstruir qué estaba ocurriendo.
5. Patrones temporales
La actividad automatizada suele dejar una huella temporal bastante característica.
6. Cabeceras adicionales
El User-Agent es solamente una pieza del rompecabezas.
7. Comportamiento
Esta es probablemente la variable más interesante:
No preguntarse solamente «¿quién dice ser?», sino «¿cómo se comporta?»
Y aquí aparece una regla de oro
Para controles de seguridad:
No confíes en una identidad que el propio cliente puede modificar.
Esto se aplica al User-Agent, pero también a otros datos proporcionados directamente por el cliente.
Un servidor debe utilizar mecanismos apropiados de autenticación, autorización, control de acceso y validación.
Si realmente necesitamos saber si una petición procede de un servicio concreto, la solución no debería ser simplemente:
User-Agent == "NombreDelServicio"sino utilizar mecanismos de verificación adecuados al caso.
¿Qué hacer con un .env expuesto?
Aquí conviene ser tajante.
Si un servidor web permite descargar públicamente un .env que contiene secretos, el problema no es el bot que lo ha encontrado.
El problema existía antes.
El crawler simplemente ha encontrado la puerta que estaba abierta.
La respuesta adecuada incluye, según el caso:
- impedir que esos archivos sean servidos por el servidor web;
- revisar la configuración del servidor;
- almacenar secretos fuera de los directorios públicos;
- rotar inmediatamente credenciales potencialmente expuestas;
- revisar registros de acceso;
- comprobar si otros archivos sensibles están accesibles;
- investigar posibles accesos anteriores;
- revisar configuración de despliegue y permisos.
Y un detalle importante: borrar el .env después de una exposición no necesariamente soluciona el incidente. Si contenía credenciales, esas credenciales deben considerarse potencialmente comprometidas y revisarse/rotarse.
Por eso, ante este tipo de actividad, la pregunta interesante no debería ser únicamente «¿qué bot es este?», sino:
«¿Qué está intentando descubrir, qué respuestas está obteniendo y por qué nuestro servidor permitiría que un cliente automatizado llegue hasta ahí?»
Ahí es donde un conjunto aparentemente caótico de User-Agent empieza a convertirse en información de seguridad útil.